Sistemas
Copias, monitorización y nube para una pyme sin departamento de sistemas
Taiko Solutions · 26 de junio de 2026
La mayoría de las pymes se entera de que un servidor ha caído cuando un cliente llama enfadado. O descubre que el backup fallaba cuando ya es tarde para que sirva de algo. No es un problema de tecnología: es no tener a nadie cuyo trabajo sea mirar estas cosas antes de que se conviertan en un problema.
Esto es lo que hemos aprendido llevando infraestructura, propia y de clientes, sin tener detrás una plantilla dedicada a ello: no hace falta construir un departamento de sistemas, hace falta cubrir tres cosas concretas, en el orden correcto.
Lo mínimo, en el orden que importa
- Copias que se puedan restaurar. No copias que se hagan; copias que, si hace falta, devuelven el sistema a un estado usable. Es la diferencia entre tener una copia de los archivos y poder levantar el servicio entero en otra máquina si la original falla.
- Avisos antes de que llame el cliente. Alguien tiene que enterarse de que un servicio ha dejado de responder, o de que un disco se está llenando, antes de que lo note quien lo usa. Si el primer síntoma de un problema es una llamada de un cliente enfadado, ya se ha llegado tarde.
- Saber dónde vive cada cosa. Qué máquina o proveedor aloja qué, quién tiene acceso, dónde están las claves. Parece obvio hasta que hay que resolver una incidencia un sábado y la respuesta es “no sé, eso lo llevaba tal persona que ya no está”.
El orden importa porque cada punto depende del anterior. No sirve de nada monitorizar un backup que nunca se ha probado a restaurar, y no sirve de nada saber dónde vive cada cosa si nadie avisa cuando algo de eso deja de funcionar.
Copias que se restauran, no copias que se hacen
Un backup que nunca se ha restaurado no es un backup, es una esperanza. Lo hemos visto fallar de las dos formas típicas: el job que se queda en verde pero copia una carpeta equivocada, y el backup que sí es correcto pero nadie sabe cómo levantarlo cuando hace falta con prisa.
Lo que funciona, en nuestra experiencia, tiene tres piezas:
- Automatizado, no manual. Lo que depende de que alguien se acuerde de hacerlo, tarde o temprano falla.
- Separando datos de configuración. Si los servicios corren en contenedores, los volúmenes de datos se respaldan aparte del propio stack que los levanta. Así se puede reconstruir el servicio, no solo recuperar archivos sueltos.
- Probado de verdad, no solo en verde. Restaurar de vez en cuando, aunque sea sobre una máquina de pruebas, para comprobar que lo que se guarda sirve para algo el día que haga falta.
Para una empresa pequeña, sin margen para perder un día reconstruyendo algo a mano, esto no es una capa de más: es la base sobre la que se apoya todo lo demás. La pregunta que de verdad importa no es “¿tengo copia de mis archivos?”, sino “¿puedo levantar el servicio entero en otra máquina si la mía falla, y en cuánto tiempo?”. La primera pregunta la responde cualquier backup. La segunda solo la responde uno que se ha probado.
Avisos antes de que llame el cliente
La monitorización tiene mala fama de cosa de empresa grande, pero el principio es sencillo: si mantienes infraestructura, ya sea la tuya o la de un cliente, necesitas saber que algo va mal antes de que se note fuera.
Lo mínimo que merece la pena vigilar es esto:
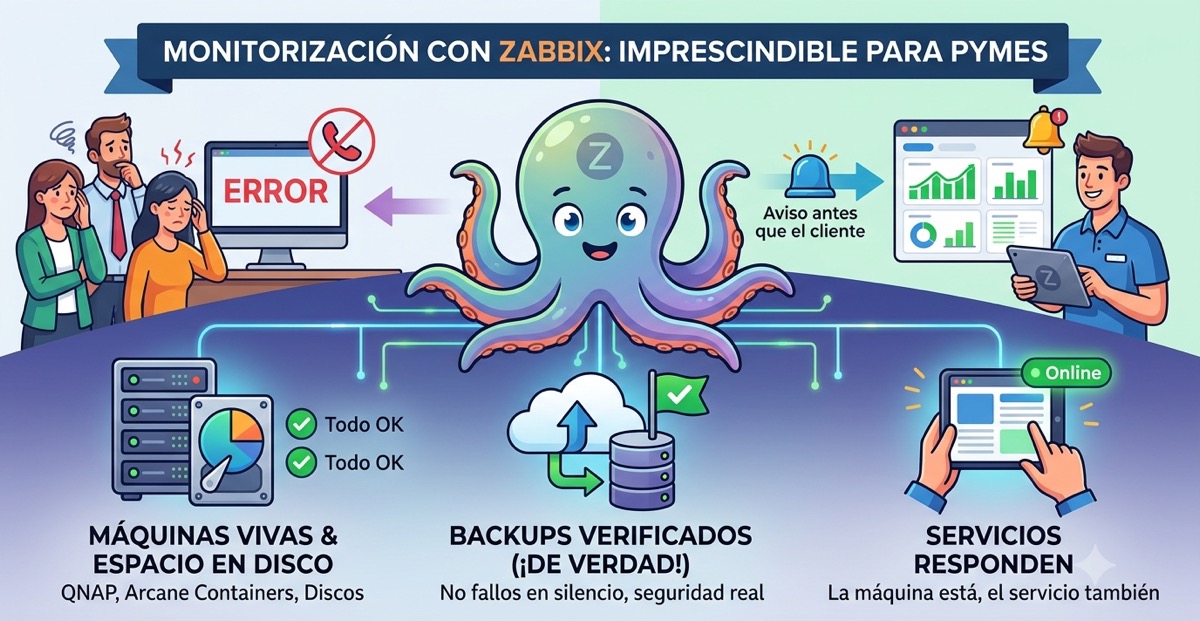
- Que las máquinas están vivas y con espacio. El servidor central, los contenedores que corren encima, el disco que se llena sin avisar.
- Que las copias se han hecho de verdad. Un backup que falla en silencio es peor que no tener backup: da una falsa sensación de seguridad hasta que se necesita.
- Que los servicios responden. No basta con que la máquina esté encendida; el servicio tiene que contestar cuando alguien lo usa.
Nosotros lo hacemos con Zabbix, pero la herramienta concreta importa menos que tener alguna. Lo que separa “lo arreglamos antes de que nadie lo note” de “perdón, no sabíamos que estaba caído” es tener ese margen de aviso.
Dónde vive cada cosa
Cuando hay pocas manos y ninguna dedicada en exclusiva a sistemas, la pregunta “¿dónde está esto?” se vuelve crítica. En nuestra propia infraestructura, buena parte de la operación (control de versiones, contenedores, backups, almacenamiento del equipo) corre sobre un NAS central, y eso lo hemos aprendido a valorar tanto como a vigilar: un solo punto que lo aguanta todo es cómodo, y por eso mismo necesita backups que salgan de esa misma máquina y monitorización que avise si falla.
No todas las pymes quieren o pueden mantener algo así en su propia oficina. Self-hostear no es “montarlo y olvidarlo”: es mantenimiento continuo, aunque a cambio da control total y previsibilidad de costes. Si no hay nadie que quiera encargarse de ese mantenimiento, la alternativa razonable es mover lo que antes vivía en una máquina física a un proveedor que se encarga de la parte de abajo: el hardware, la disponibilidad, buena parte de la seguridad de la infraestructura. Ninguna opción es mejor en abstracto; depende de si tu empresa quiere (y puede) dedicar tiempo a mantener algo propio.
Es el terreno en el que trabajamos como IONOS Silver Partner, acompañando a pymes que necesitan que copias, avisos y alojamiento estén resueltos sin tener que construir un departamento de sistemas para conseguirlo. Puedes ver cómo lo planteamos en sistemas y cloud.
Lo que nos llevamos
Ninguna de estas tres cosas (copias que se restauran, avisos que llegan antes que el cliente, saber dónde está cada pieza) exige tener un departamento de sistemas. Exige haberlo montado una vez, bien, y no darlo por hecho después. Si tu empresa no tiene a nadie dedicado a esto, no es una razón para no tenerlo resuelto: es la razón por la que conviene resolverlo desde fuera. Si quieres que revisemos cómo está montado hoy lo tuyo, puedes escribirnos a través de contacto.