FileMaker
Data API u oData en FileMaker: cuándo usar cada una
Taiko Solutions · 14 de julio de 2026
FileMaker tiene dos formas de exponer tus datos por API, y elegir mal te complica el proyecto durante meses. Cuando hay que integrar FileMaker con el mundo exterior (una web, otra aplicación, un agente de IA) aparecen dos caminos: la Data API y oData. Las dos son REST, las dos van sobre HTTPS, y a primera vista parecen intercambiables. No lo son, porque resuelven cosas distintas.
Este artículo recoge el criterio que aplicamos nosotros para decidir, y el error más habitual al hacerlo.
La Data API: control fino cuando el cliente lo escribes tú
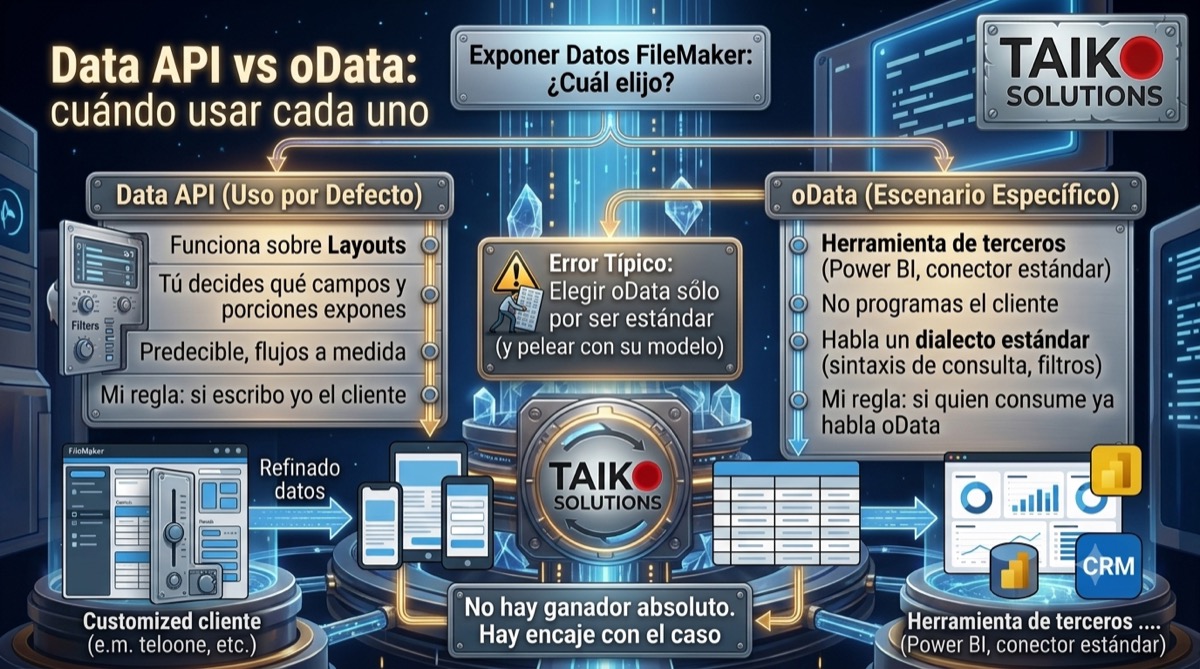
La Data API trabaja sobre layouts. Eso tiene una consecuencia práctica importante: decides exactamente qué campos y qué porciones de los datos expones, porque lo que se ve por la API es lo que has puesto en el layout. Es predecible, y resulta muy cómoda para flujos a medida.
Es la que usamos por defecto cuando controlamos las dos puntas: la aplicación FileMaker y el cliente que la consume. Por ejemplo, una web o un portal que habla solo con una base de datos concreta, en el que nosotros definimos qué datos entran y salen. Ese es el tipo de proyecto que encaja con un portal web conectado a FileMaker.
oData: cuando quien consume es una herramienta que ya habla ese idioma
oData brilla en otro escenario: cuando una herramienta de terceros, como Power BI o un conector estándar, tiene que consumir tus datos sin que tú programes el cliente. oData habla un dialecto estándar de la industria, con su propia sintaxis de consulta, filtros y relaciones incluidos de fábrica.
La ventaja es evidente: si la herramienta que va a leer los datos ya entiende oData, no hay que escribir ni mantener nada en medio. Se apunta la herramienta a FileMaker y funciona con las convenciones que ya conoce.
Nuestra regla práctica
Si escribimos nosotros el cliente, Data API. Si quien consume es una herramienta externa que ya habla oData, oData, y nos ahorramos trabajo.
Dicho de otra forma, la pregunta que hay que hacerse no es “cuál es mejor”, sino “quién va a consumir esto”. Si la respuesta es “un programa que escribimos a medida”, queremos el control sobre qué se expone y cómo. Si la respuesta es “una herramienta que ya existe y que no vamos a tocar”, queremos que hable su idioma sin que tengamos que traducir.
Hay un matiz que conviene tener presente: tampoco son excluyentes. En una misma empresa puede haber una web que consume la Data API y, al lado, una herramienta de análisis que lee por oData. Cada una por el camino que le corresponde.
El error típico
El error más frecuente es elegir oData “porque es estándar” y acabar peleándose con su modelo cuando lo que hacía falta era el control fino de la Data API. O al revés: montar un cliente a medida contra la Data API cuando lo que se necesitaba era enchufar una herramienta que ya hablaba oData y no había nada que programar.
En ambos casos el problema es el mismo: se decide por la etiqueta de la tecnología y no por el caso de uso. Y se nota meses después, cuando cada cambio cuesta más de lo que debería porque se está forzando una herramienta a hacer algo que no es lo suyo.
Un caso nuestro: vigilar FileMaker desde Zabbix
Lo vivimos al montar la vigilancia de nuestra automatización de facturas. El proceso deja en FileMaker una señal de vida (cuándo se ejecutó por última vez, cuánto lleva esperando lo más antiguo de la cola y cuántas facturas quedan pendientes), y nuestro Zabbix la consulta cada minuto para avisar por Slack si algo se atasca.
Según nuestra propia regla, era un caso de oData: quien consume es una herramienta que no programamos nosotros y que solo tiene que leer unos pocos valores. Y lo fue. Pero “habla el estándar” no quiere decir “funciona a la primera”. Nos encontramos tres trampas, y ninguna era un fallo de FileMaker:
- Un error 8309, “el campo no existe”. El campo existía; lo que pasaba es que la cuenta con la que se conectaba Zabbix no tenía privilegio sobre él. La solución fue darle acceso, y mejor aún, darle a quien lee una cuenta propia con lo justo.
- Las horas llegaban desfasadas. oData marcaba la hora local del servidor como si fuera hora universal. En lugar de corregirlo fuera, dejamos de hacer cuentas de fechas en Zabbix: que FileMaker calcule directamente cuántos segundos han pasado.
- Un campo de “antigüedad” que siempre valía cero. Era un cálculo almacenado, así que se congelaba en el momento de guardar el registro. Al hacerlo no almacenado, se recalcula cada vez que se consulta.
Las tres tienen algo en común: el sistema no fallaba, respondía otra cosa de la que creíamos estar preguntando. Elegir bien entre Data API y oData te ahorra pelearte con el modelo equivocado, pero no te ahorra conocer el que eliges. Lo contamos con más detalle en la chuleta de nuestra charla en fmCat 2026.
Y si lo que consume es un agente de IA
El mismo criterio sirve para integrar un agente de IA. Si queremos controlar con precisión qué ve y qué puede hacer, lo habitual es acotarlo con un diseño propio. Si ya hay un conector estándar que resuelve lo que necesitamos, se aprovecha. Para el caso concreto de conectar modelos de IA con FileMaker, tenemos además nuestro trabajo en Agentic FM, y la visión general en inteligencia artificial para procesos de negocio.
Lo que nos llevamos
No hay ganador absoluto. Hay encaje con el caso. Antes de decidir, conviene tener claro quién va a consumir los datos y cuánto control necesitas sobre lo que se expone; con esas dos respuestas, la elección suele salir sola. Si tienes una integración con FileMaker en mente y dudas por dónde empezar, puedes escribirnos a través de contacto; y si ya has pasado por esta decisión, nos interesa saber qué elegiste y por qué.