Sistemas
Cuatro avisos de seguridad en cinco semanas: por qué dejamos de solo parchear
Taiko Solutions · 17 de noviembre de 2026
Entre finales de septiembre y finales de octubre recibimos cuatro avisos de seguridad que afectaban a servidores que gestionamos, nuestros y de clientes. En ninguno de los cuatro entró nadie. Pero los cuatro nos dejaron la misma conclusión: parchear cuando sale el parche ya no basta. Los ataques no se van a parar; lo que podemos cambiar es cuánto tardamos en enterarnos y en responder.
Este artículo cuenta qué pasó, qué hemos montado desde entonces y dónde encaja la IA en todo ello. No entra en configuraciones concretas: contar umbrales, puertos o reglas exactas solo ayudaría a quien quiera saltárselos.
Cuatro avisos en cinco semanas
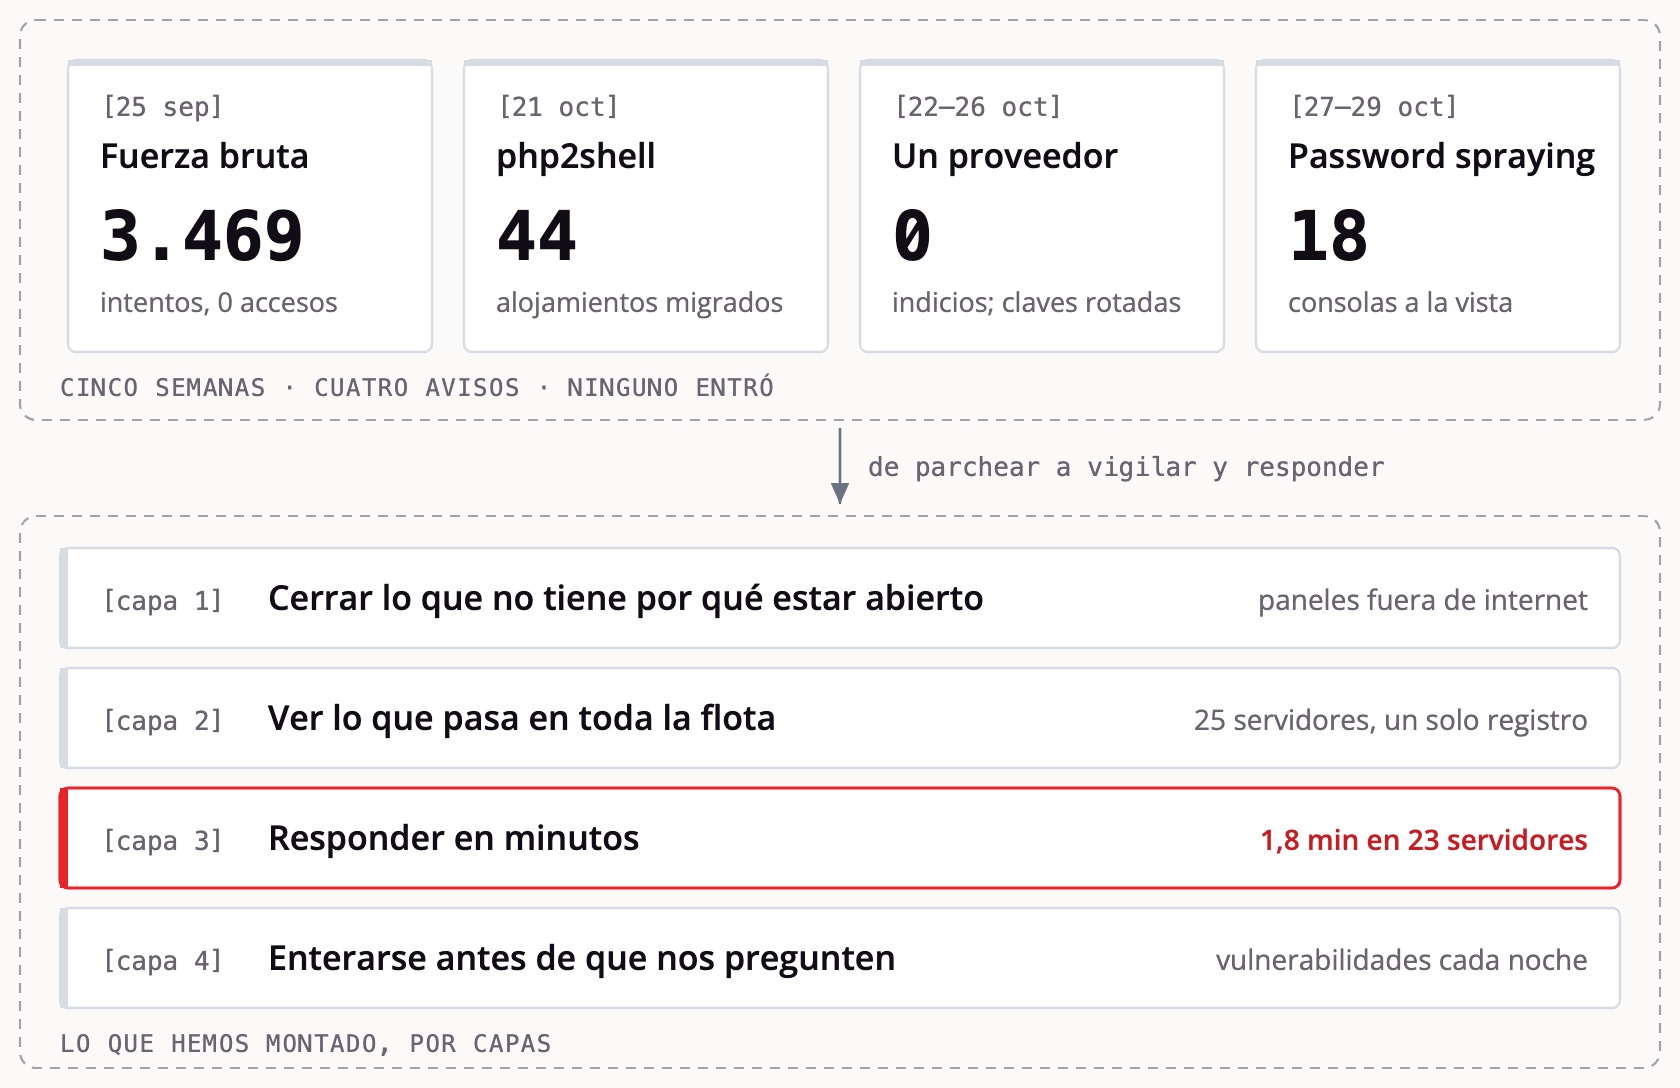
25 de septiembre: fuerza bruta contra los paneles de Plesk. Un ataque coordinado contra tres paneles de Plesk a la vez, con cientos de direcciones distintas que probaban usuarios como admin o root muy pocas veces cada una. En total, 3.469 intentos desde más de 500 direcciones y ningún acceso. Lo preocupante no fue el volumen, sino el ritmo: cada dirección iba tan despacio que la protección por defecto contra fuerza bruta no llegaba a saltar. En uno de los servidores, ni una sola de las direcciones atacantes era española.
21 de octubre: php2shell. Dos vulnerabilidades críticas de PHP que permitían ejecutar código en el servidor sin autenticarse. Al día siguiente un cliente nos preguntó por correo si estaba afectado. Revisamos nuestro hosting principal: de 95 alojamientos, 44 usaban versiones de PHP que ya no reciben parches oficiales. Ese mismo día los pasamos a versiones mantenidas con el parche, por tandas: 44 migrados y ninguno revertido. Antes revisamos 178.000 líneas de registro desde días antes del aviso, sin ningún indicio de que alguien lo hubiera aprovechado.
22 a 26 de octubre: el incidente de un proveedor. El proveedor de una herramienta de administración para FileMaker Server sufrió un ataque y dio por comprometidas las claves de acceso que sus clientes le habían confiado. Revisamos los registros de los servidores afectados de esa semana, sin indicios de acceso, rotamos las claves y dejamos de depender de esa consola.
27 a 29 de octubre: password spraying contra FileMaker Server. Varios avisos de la comunidad, y después de la propia Claris, sobre una campaña mundial que probaba contraseñas habituales contra servidores FileMaker. Claris lo dejó claro: no es un fallo de FileMaker, sino ataques a escala, ayudados por agentes de IA, que aprovechan malas prácticas en las soluciones. Revisamos los registros de unos 14 días de todos los servidores FileMaker que gestionamos: ningún acceso correcto desde una dirección desconocida. Y aun así, el diagnóstico no fue cómodo: ningún servidor tenía bloqueo de fuerza bruta y en 18 la consola de administración se veía desde internet. En los que tenían Webmin abierto encontramos cientos de intentos fallidos en cada uno.
Cuatro avisos de origen distinto en cinco semanas. Esa frecuencia es la que nos hizo cambiar de enfoque.
Lo que hemos montado, por capas
1. Cerrar lo que no tiene por qué estar abierto
Lo primero fue reducir lo que se ve desde internet:
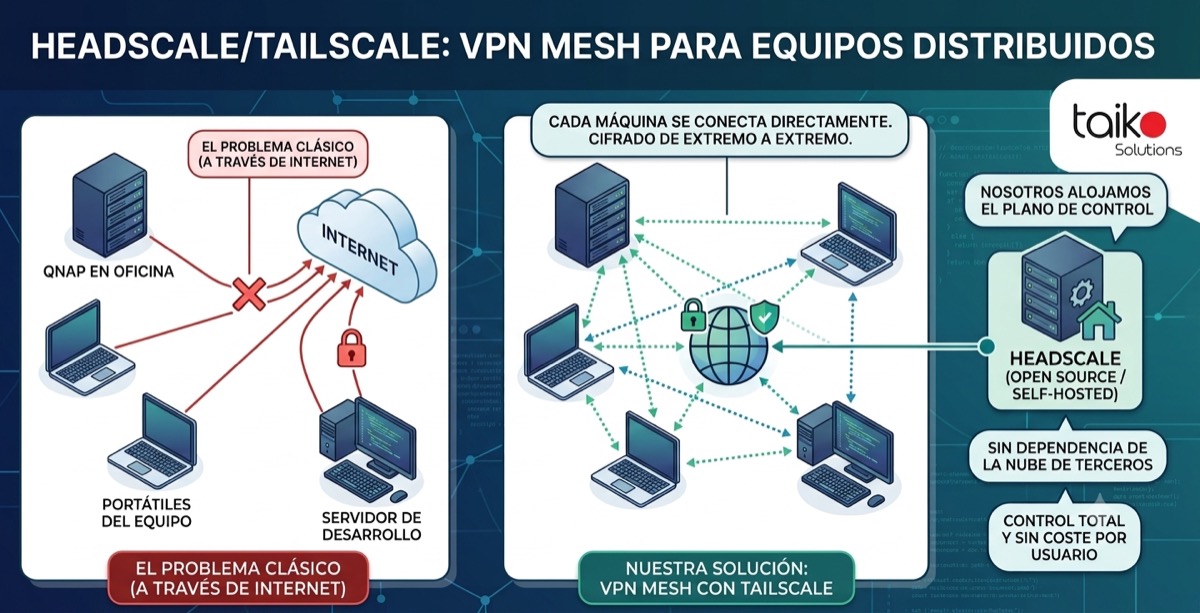
- Paneles de administración fuera de internet. Los paneles de Plesk y las consolas de FileMaker Server solo se alcanzan desde la red privada que une nuestros equipos y servidores (la contamos aquí) o desde direcciones de confianza. Las 18 consolas que se veían desde internet dejaron de verse en un día, y en los servidores Linux añadimos una segunda capa en el servidor web.
- Bloqueo de fuerza bruta en todos los servidores FileMaker Linux, con aviso a nuestro canal de servidores cada vez que salta.
- Fuera lo que no se usa. Desinstalamos Webmin donde estaba, comprobamos que ODBC y JDBC siguen cerrados y que las bases de datos están filtradas, y quitamos PHP de los sitios que no lo necesitaban.
- Bases de datos y copias. Las cuentas administrativas de MariaDB ya no aceptan conexiones desde internet. Y al revisar los sitios WordPress encontramos nueve con copias de seguridad completas descargables por cualquiera, configuración incluida, que habían dejado los plugins de copias: ahora el servidor web las bloquea en todos los Plesk.
- Contraseñas distintas por persona y por cliente, ordenadas en un gestor de contraseñas.
- Actualizaciones automáticas de Plesk y parches del kernel sin reiniciar.
Y avisamos a nuestros clientes con FileMaker Server de lo que estaba pasando y de lo que íbamos a hacer en sus servidores.
2. Ver lo que pasa en toda la flota a la vez
El ataque a Plesk nos enseñó algo incómodo: cada servidor veía unos pocos intentos y ninguno daba la alarma, aunque juntos eran miles. Por eso centralizamos los registros. Hoy 25 servidores envían sus logs a VictoriaLogs, unas 415.000 líneas al día, guardadas 30 días en nuestra propia infraestructura y con un coste prácticamente nulo.
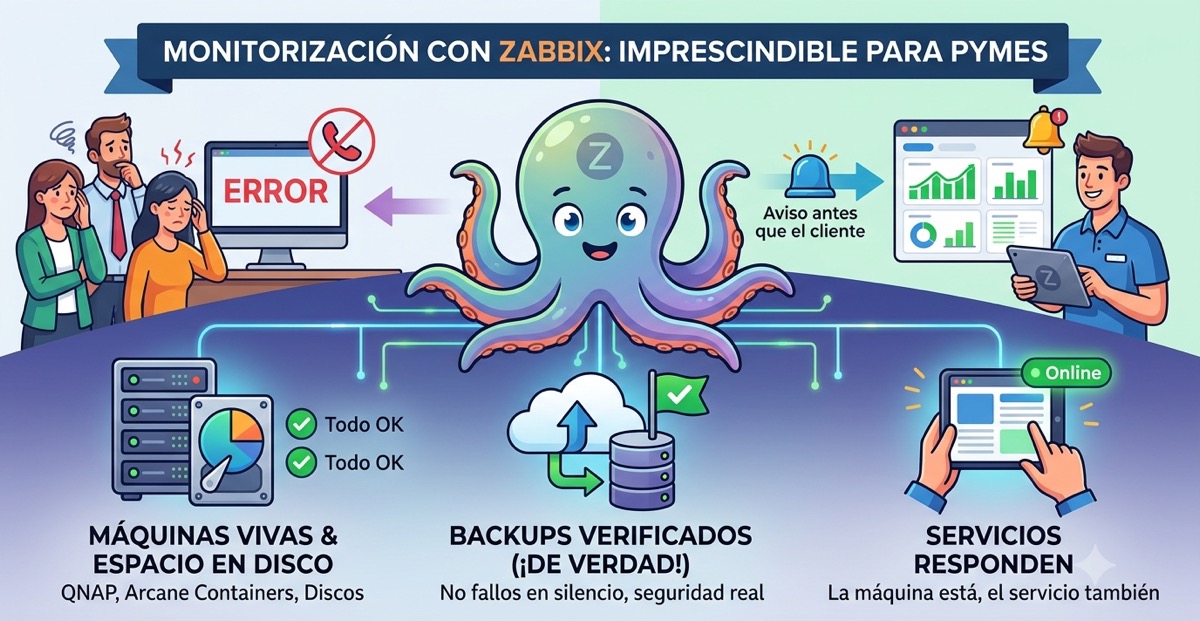
Sobre esos registros corren reglas que miran la flota entera: muchos fallos de login en un servidor, fallos repartidos entre varios servidores que ninguno vería por separado, una entrada correcta justo después de varios fallos, o una misma dirección que recorre varios servidores en poco tiempo. Al principio eran 265 avisos al día; tras una semana de ajustes, entre 10 y 15. Un aviso que nadie lee no protege a nadie. Zabbix sigue vigilando métricas, disponibilidad y copias.
3. Responder en minutos, en todos los servidores
Detectar no sirve de mucho si la respuesta es entrar servidor por servidor. Montamos un panel de seguridad, con una app de Slack, que bloquea o desbloquea una dirección en los 23 servidores de la flota a la vez. Cada acción se prueba antes en simulación, se confirma y queda registrada: quién la pidió, por qué y qué resultado dio.
4. Enterarnos de las vulnerabilidades antes de que nos pregunten
El aviso de PHP nos llegó por un cliente. No queremos que vuelva a pasar. Cada noche se analizan las imágenes de los contenedores con Trivy, y cada mañana un agente cruza las vulnerabilidades publicadas con la lista de lo que tenemos instalado. Cada aviso relevante aparece en el panel con su historia, llega a Slack y desde ahí se crea la tarea en nuestro sistema de gestión.
Dónde entra la IA
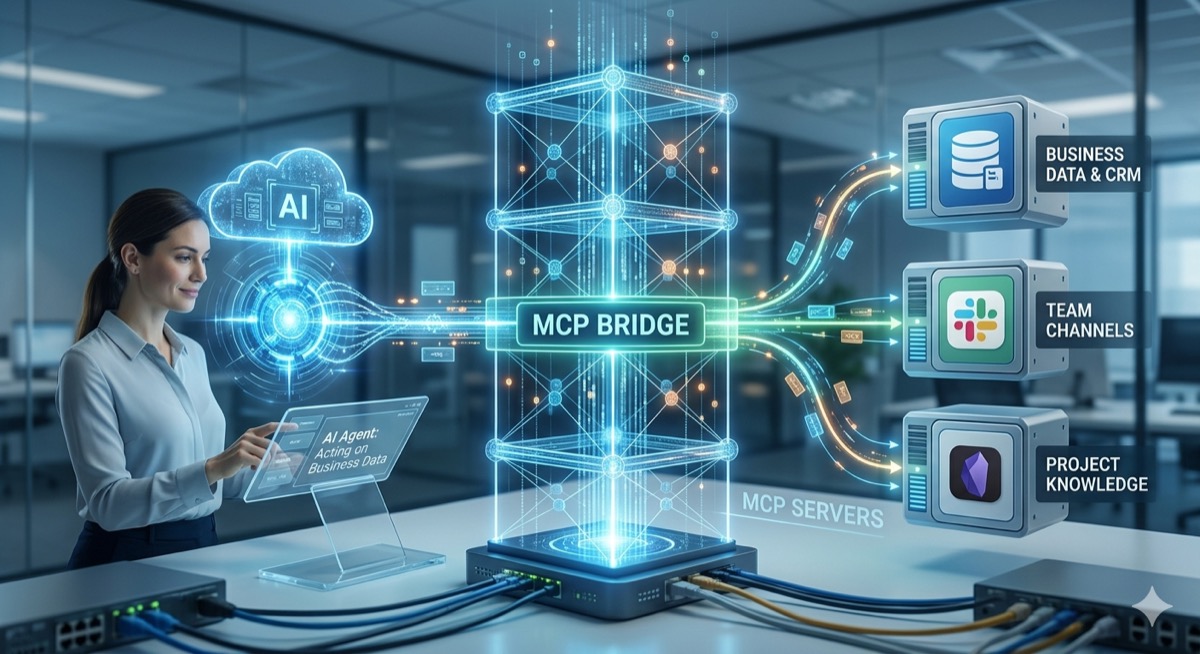
Usamos Claude Code conectado por MCP a los registros, a Zabbix y al panel de seguridad. Cuando salta un aviso, Claude investiga: qué ha hecho esa dirección, contra qué servidores, si encaja con algo conocido. Con eso redacta una propuesta. Pero no ejecuta nada por su cuenta. La IA investiga y propone; una persona decide. Cuando la decisión es actuar, la acción queda anotada en el diario de cada servidor como hecha por Claude con autorización expresa.
Para lo evidente no esperamos a nadie. Unas reglas fijas bloquean solas, de forma temporal, las direcciones de centros de datos con mala reputación pública. Para los casos dudosos, un segundo agente de IA, Hermes, da su veredicto razonado. También puede equivocarse, así que tampoco ejecuta: deja la recomendación y decide una persona. Un ejemplo real de veredicto: no bloquear, porque era una dirección española de una conexión de fibra fija.
Un caso real, del 13 de noviembre. Una sola dirección lanzó unas 5.000 peticiones en 15 minutos contra ocho de nuestros servidores, buscando ficheros de configuración y páginas de diagnóstico de PHP. Su reputación pública era la peor posible. Hermes recomendó bloquear y el panel aplicó el bloqueo en los 23 servidores en 1,8 minutos.
Del 2 al 13 de noviembre el panel registró 27 direcciones bloqueadas. La mayoría, por las reglas automáticas; el resto, desde el panel, desde Slack o a partir de propuestas de Claude. Toda la parte de IA nos costó 1,66 dólares ese mes.
Lo que no hemos delegado es la decisión. Un bloqueo mal puesto puede dejar a un cliente sin acceso a su aplicación un lunes por la mañana. La IA nos ahorra la investigación, que es lo que más tiempo lleva, y el registro nos permite revisar después qué se decidió y por qué.
Lo que revisaría hoy en tu FileMaker Server
Si administras un FileMaker Server, sin entrar en cómo lo tenemos configurado nosotros:
- La consola de administración no debería verse desde internet. Restringe su acceso y entra por una VPN o red privada.
- Bloquea la fuerza bruta y haz que el aviso le llegue a alguien. Un bloqueo que nadie ve no te dice que te están atacando.
- Revisa las cuentas. Nada de cuentas de administrador compartidas ni de contraseñas repetidas entre servidores o clientes; revisa la cuenta de invitado y las cuentas genéricas con acceso total.
- Cierra lo que no uses: ODBC y JDBC, paneles como Webmin, herramientas de terceros expuestas. Y activa el filtrado de bases de datos.
- Saca los registros del servidor. Si solo los miras dentro de cada máquina, no verás un ataque repartido entre varias.
- Si un proveedor tuyo sufre un incidente, rota sus claves ese mismo día, aunque todavía no sepas si te afecta.
No parchear más, sino enterarse antes
Ninguno de los cuatro avisos acabó en una intrusión, y no queremos atribuirnos más mérito del que tiene. Parte fue tener las cosas razonablemente en orden; parte, suerte. Lo que sí cambió es el enfoque. Antes esperábamos al parche y lo aplicábamos. Ahora intentamos ver lo que pasa en todos los servidores a la vez, responder en minutos y dejar escrito por qué se hizo cada cosa.
Las herramientas cambiarán, y los ataques también. La idea, no: cerrar lo que no tiene por qué estar abierto, mirar la flota entera, dejar que la IA haga el trabajo pesado de investigar y que la decisión la tome una persona.
Si quieres saber cómo cuidamos los servidores de nuestros clientes, lo contamos en sistemas y cloud. Y si tienes dudas sobre tu FileMaker Server, puedes escribirnos desde contacto.